Opus 5.5와 함께한 대 AI 시대의 '딸깍' 마이그레이션 리포트: EC2 → Lightsail 8GB, 다운타임 15분
 이전하는 15분 동안 모든 사이트에 떠 있던 점검 페이지
내 사이드 프로젝트 전부(코인충·여기얼마·에브리메이플·Scheduly·롤충·GravEx 채팅 등 사이트 18곳)를 EC2에서 Lightsail 8GB 한 대로 옮겼다. 서비스가 멈춘 시간은 15분, 데이터 손실은 0건, 데이터 전송비는 0원이다.
근데 이번에 내가 한 건 거의 없다. 슬랙에서 Jarvis(집 PC에서 도는 Opus 5.5)랑 대화하면서 "응 해 봐", "지금 바로 해 줘" 정도만 했고, 실험 설계부터 DB 이전, DNS 교체, 배포 설정까지는 전부 AI가 했다. 진짜 딸깍 마이그레이션 ㅋㅋ
한눈에 보기
| 전 | 후 | |
|---|---|---|
| 서버 | EC2 t3.medium (2코어·4GB·디스크 80GB) + Lightsail 2GB (업비트 웹소켓 프록시) | Lightsail 8GB 한 대 (2코어·8GB·디스크 160GB) |
| 메모리 여유 | 0GB (스왑까지 씀) | 2.2GB |
| 디스크 | 78GB 중 59GB (76%) | 154GB 중 45GB (29%) |
| CPU 기준선 | 20% (넘으면 크레딧, 다 쓰면 초과 과금) | 30% (넘으면 크레딧, 다 쓰면 느려질 뿐 과금 없음) |
| 무료 데이터 전송 | 월 100GB (넘으면 GB당 $0.126) | 월 5TB 포함 |
| 월 비용 | 약 $49 | 약 $47 (예약 인스턴스가 끝나는 2027년 3월부터) |
걸린 시간은 이렇다.
- 처음 얘기 꺼낸 날부터 끝날 때까지: 이틀 (11/3 저녁 검토 → 11/4 오전 실험 → 오후 3시 전환 완료)
- 11/4 당일 벽시계: 3시간 40분 (11:26 실험 시작 → 15:06 이전 완료). 이 중 2시간쯤은 DB 덤프·복원 기다리는 시간
- AI 작업 시간: 약 1시간 반
- 내 시간: 슬랙 메시지 십몇 개 + 회사 맥에서 hosts 파일 고쳐서 써 본 10분
- 서비스 중단: 14:51 ~ 15:06, 15분
왜 옮겼나
5월에 업비트 웹소켓 프록시만 Lightsail로 뺐던 건 아주 좋은 결정이었다. 근데 그 뒤로 EC2에 이것저것 계속 얹다 보니 한계가 왔다.
- 메모리 여유 0GB. 4GB 안에 Postgres, Redis, Typesense, Node 서버 여러 개, Go 서버 여러 개, Grafana·Loki까지 다 돌고 있었다. 10월 28일엔 무거운 쿼리 하나에 메모리가 바닥나서 서버가 30분 동안 통째로 먹통이 된 적도 있다 (SSH도 안 붙음 ㅠㅠ)
- 디스크 76%. 그중 Postgres가 32GB, 여기얼마 국토 실거래 DB 하나가 28GB였다
- CPU 크레딧 감소. 하루 평균 CPU가 18%에서 26%로 올라서 크레딧이 사흘 새 540 → 271로 반 토막. t3는 무제한 모드라 크레딧이 바닥나면 초과분이 요금으로 붙는다
- 서버 두 대 관리. 웹소켓 프록시 하나 때문에 서버를 따로 두는 것도 귀찮았다
그래서 목표는 EC2 t3.medium과 Lightsail 2GB를 더 이상 안 쓰고 Lightsail 8GB($44/월) 한 대로 합치기. 8GB 플랜은 메모리 8GB, 디스크 160GB, 데이터 전송 5TB가 다 들어 있는데, 지금 두 대 합친 값보다 싸다.
1단계: 일단 실험 (비용 $0.1)
바로 옮기기 전에 Jarvis가 실험부터 하자고 했다. Lightsail 8GB를 하루짜리로 띄워서 운영 DB를 통째로 덤프·복원해 보고, 무거운 쿼리를 양쪽에서 똑같이 돌려서 비교하는 거다. 판단 기준은 "EC2보다 1.5배 넘게 느리면 다시 생각하자"였다.
결과는 그냥 통과.
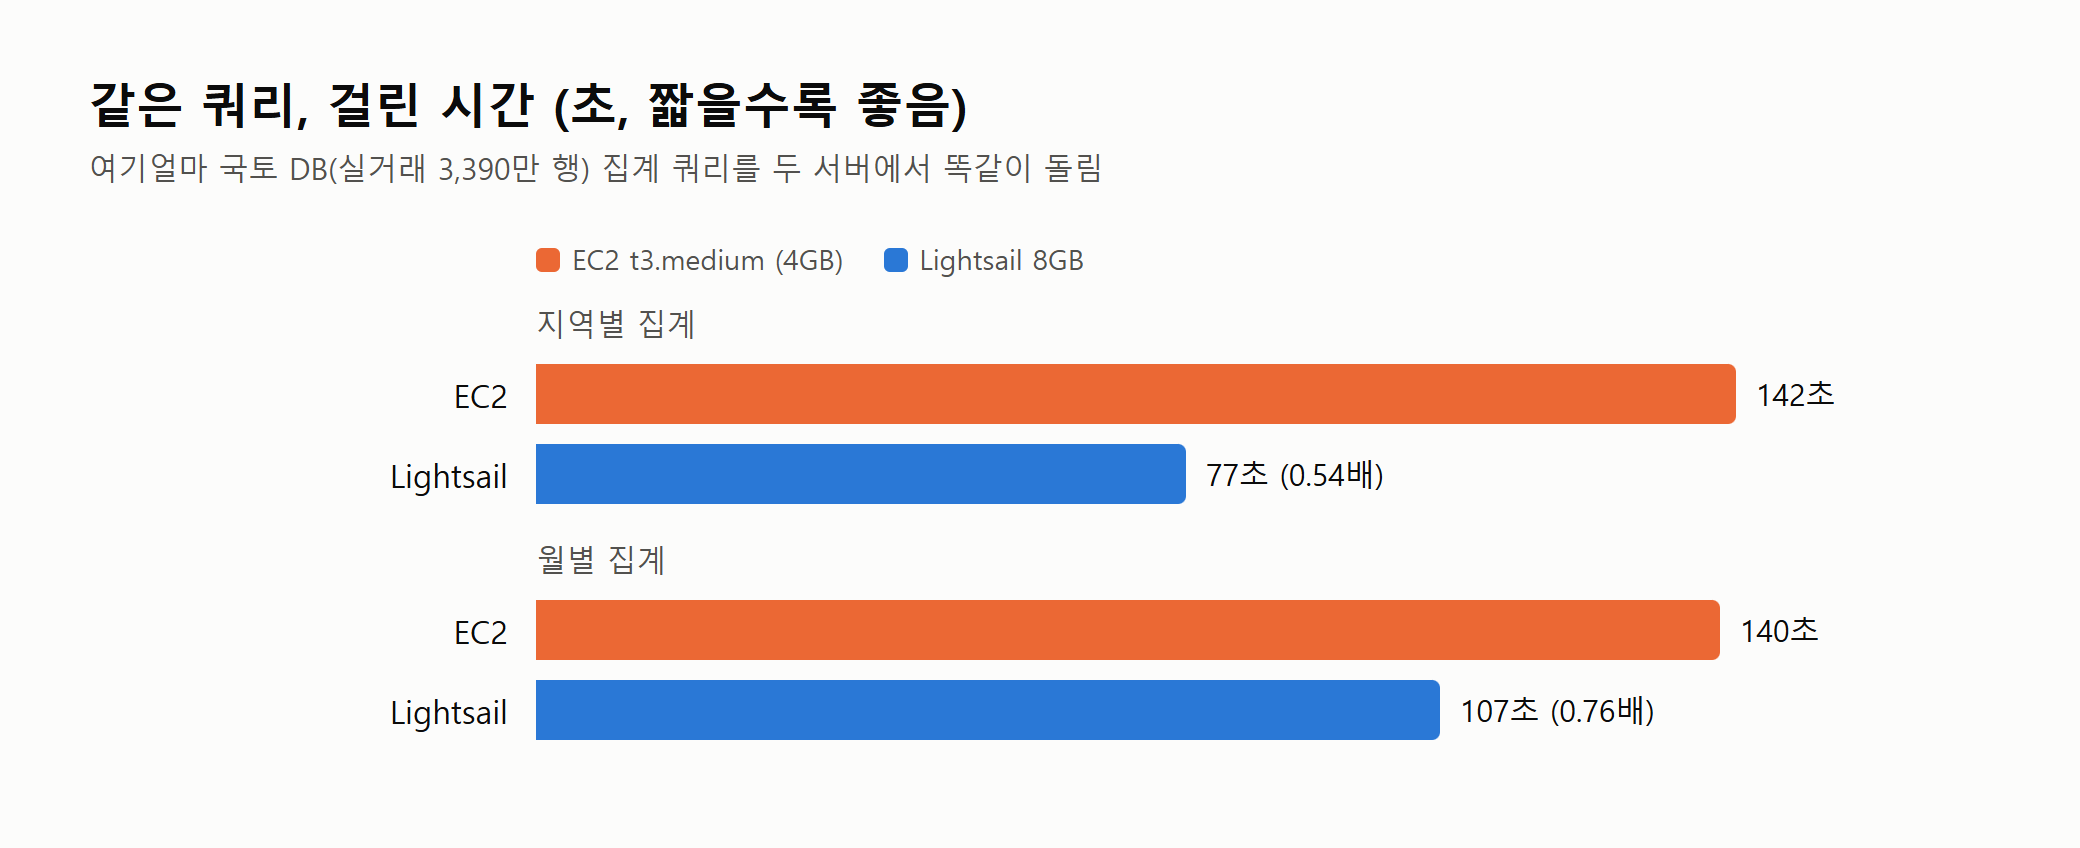
- CPU는 둘 다 똑같은 Xeon Platinum 8259CL이었다. Lightsail도 결국 안에서는 EC2다
- 같은 쿼리가 EC2 대비 0.5~0.9배 시간. 지역별 집계 142초 → 77초, 월별 집계 140초 → 107초. EC2는 운영 트래픽을 받으면서 잰 거라 Lightsail이 좀 유리하긴 했다
- 덤프 13분 + 복원 28분
60GB 옮기는데 egress 폭탄 맞는 거 아냐?
이게 제일 걱정이었는데, 실제로 네트워크를 탄 건 DB 전부 합쳐 3.5GB였다. 국토 DB는 28GB가 1.6GB가 됐다.
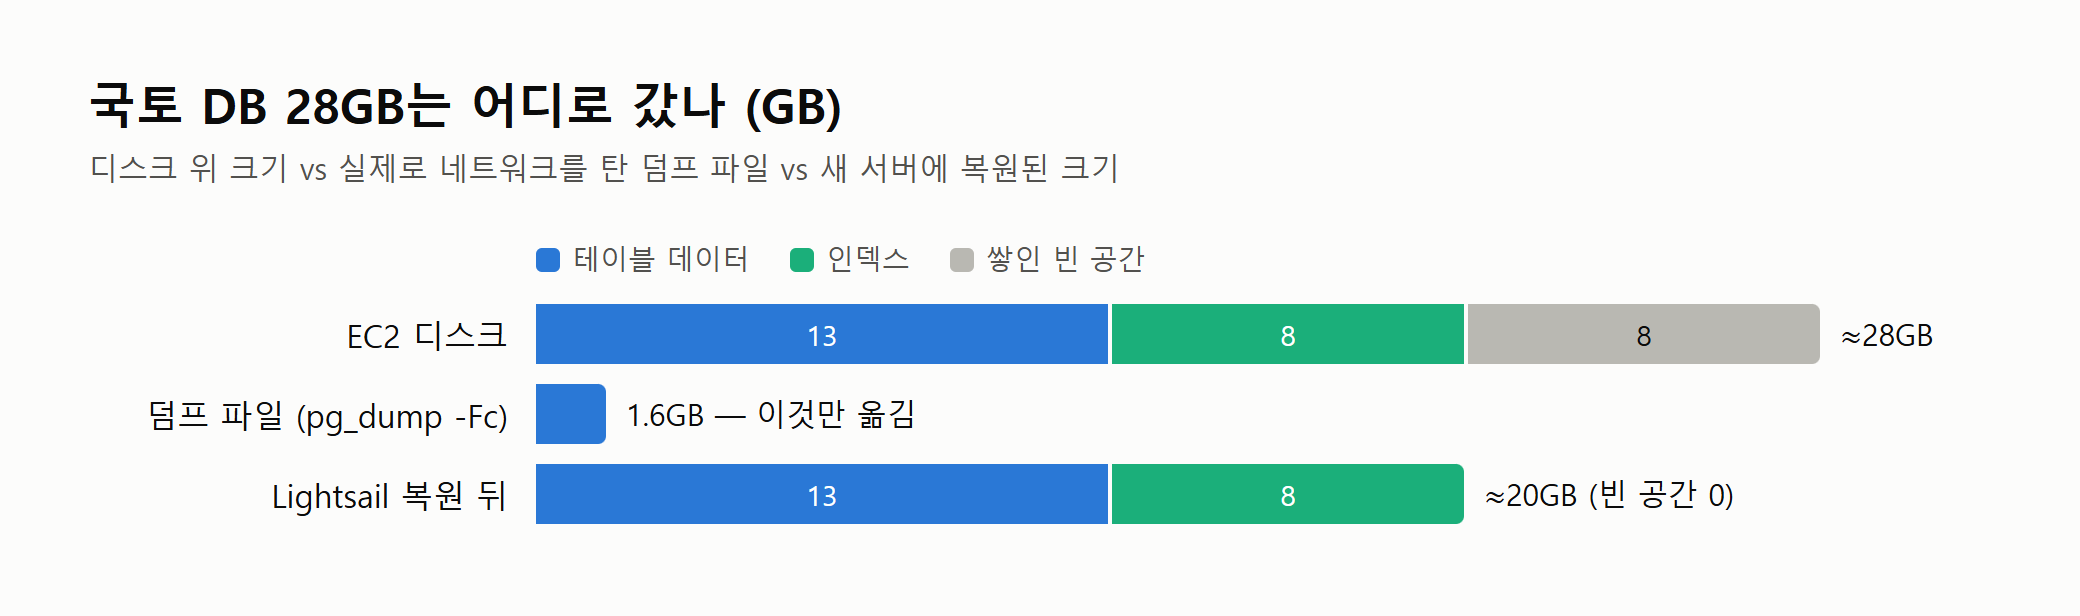
- 쌓인 빈 공간 8GB: 지우거나 고친 행이 남긴 자리다. 덤프는 살아 있는 행만 뜨니까 이건 아예 안 옮긴다
- 인덱스 8GB: 덤프엔 "이 인덱스 만들어라" 한 줄만 들어가고, 받는 쪽에서 다시 만든다
- 진짜 데이터 13GB → 1.6GB: 실거래 표가 3,390만 행인데, 시군구·동·아파트 이름·날짜가 수천만 번 되풀이되다 보니 압축이 1/8까지 된다
덤으로 새 서버에서 복원하니까 빈 공간이 빠져서 28GB → 20GB가 됐다. EC2→인터넷 전송은 계정 전체로 월 100GB까지 무료라 egress는 0원. Lightsail은 받는 트래픽이 무료다.
그럼 처음부터 압축해서 저장하면 되지 않냐고 물어봤는데, DB는 "이 한 행만 바로 읽고 고치기"가 빨라야 해서 그렇게 안 한다고 한다. 통째로 압축해 두면 한 행 보려고 덩어리를 다 풀어야 하고, 인덱스가 가리키는 자리도 계속 바뀐다. 디스크를 더 쓰고 속도를 사는 구조라는 거다. 반대로 열 단위로 압축 저장하는 ClickHouse 같은 DB는 집계엔 엄청 빠른데 한 행 고치기가 느리다. 국토 실거래처럼 쌓기만 하고 집계만 자주 도는 데이터엔 그쪽이 맞는 모양이라, 집계가 불편해지면 그때 보기로 했다.
2단계: 새 서버에 전부 다시 띄우고 dogfooding
실험 통과하자마자 "내 모든 제품 다시 띄워 주면 내가 써 볼게" 했더니 한 시간 반 만에 다 올라왔다.
- 사이트 18곳 (코인충·btc·블로그, 여기얼마, 에브리메이플, Scheduly, 롤충, GravEx 채팅·콘솔, Grafana 등)
- DB 10개 (Postgres), Redis, Typesense, nginx 설정·인증서, pm2·systemd 서비스
- 크론·알림·워커·백업은 전부 꺼 둔 채로. 사본 서버에서 알림이나 메일이 두 번 나가면 안 되니까. 꺼 둔 목록은 서버에 파일로 남겨서 전환할 때 그대로 되돌렸다
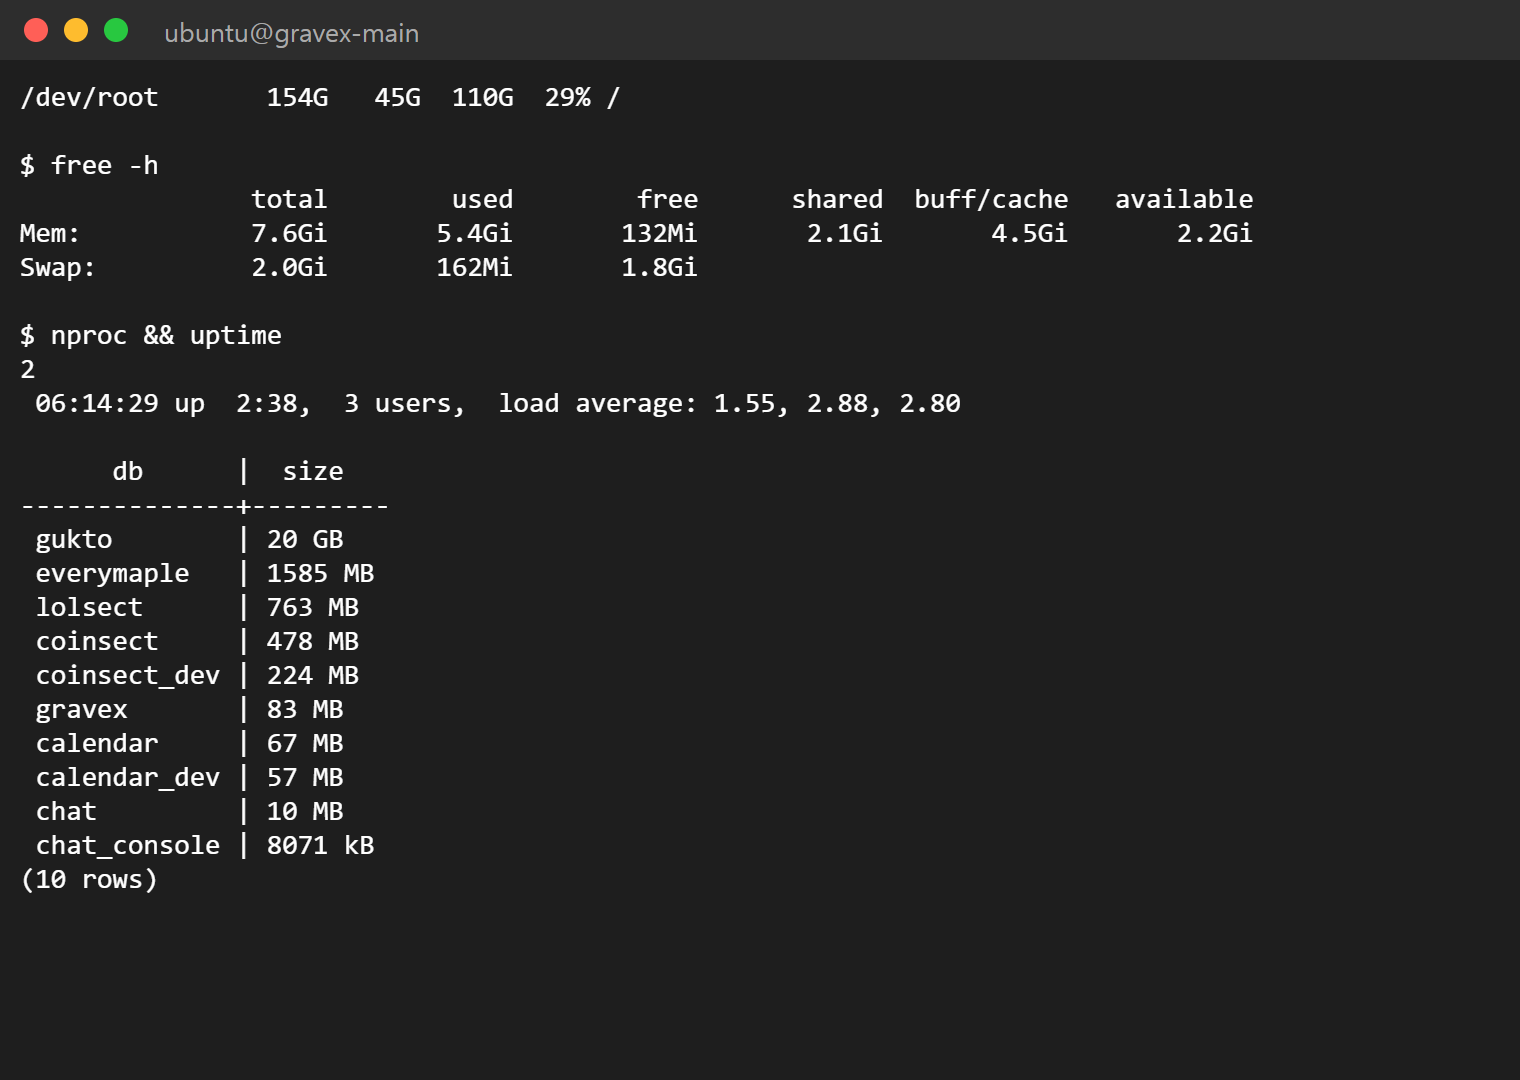 새 서버 디스크·메모리·DB 크기. 국토 DB가 20GB로 줄어 있다
시험은 회사 맥의 hosts 파일에 도메인들을 새 서버 IP로 적어서 했다. 그러면 내 맥에서만 새 서버로 가고 다른 사람들은 계속 EC2를 본다. 코인충·여기얼마·에브리메이플·Scheduly 전부 로그인 상태까지 그대로 떴다. 데이터가 사본이니까 당연한 건데 그래도 신기함 ㅋㅋ
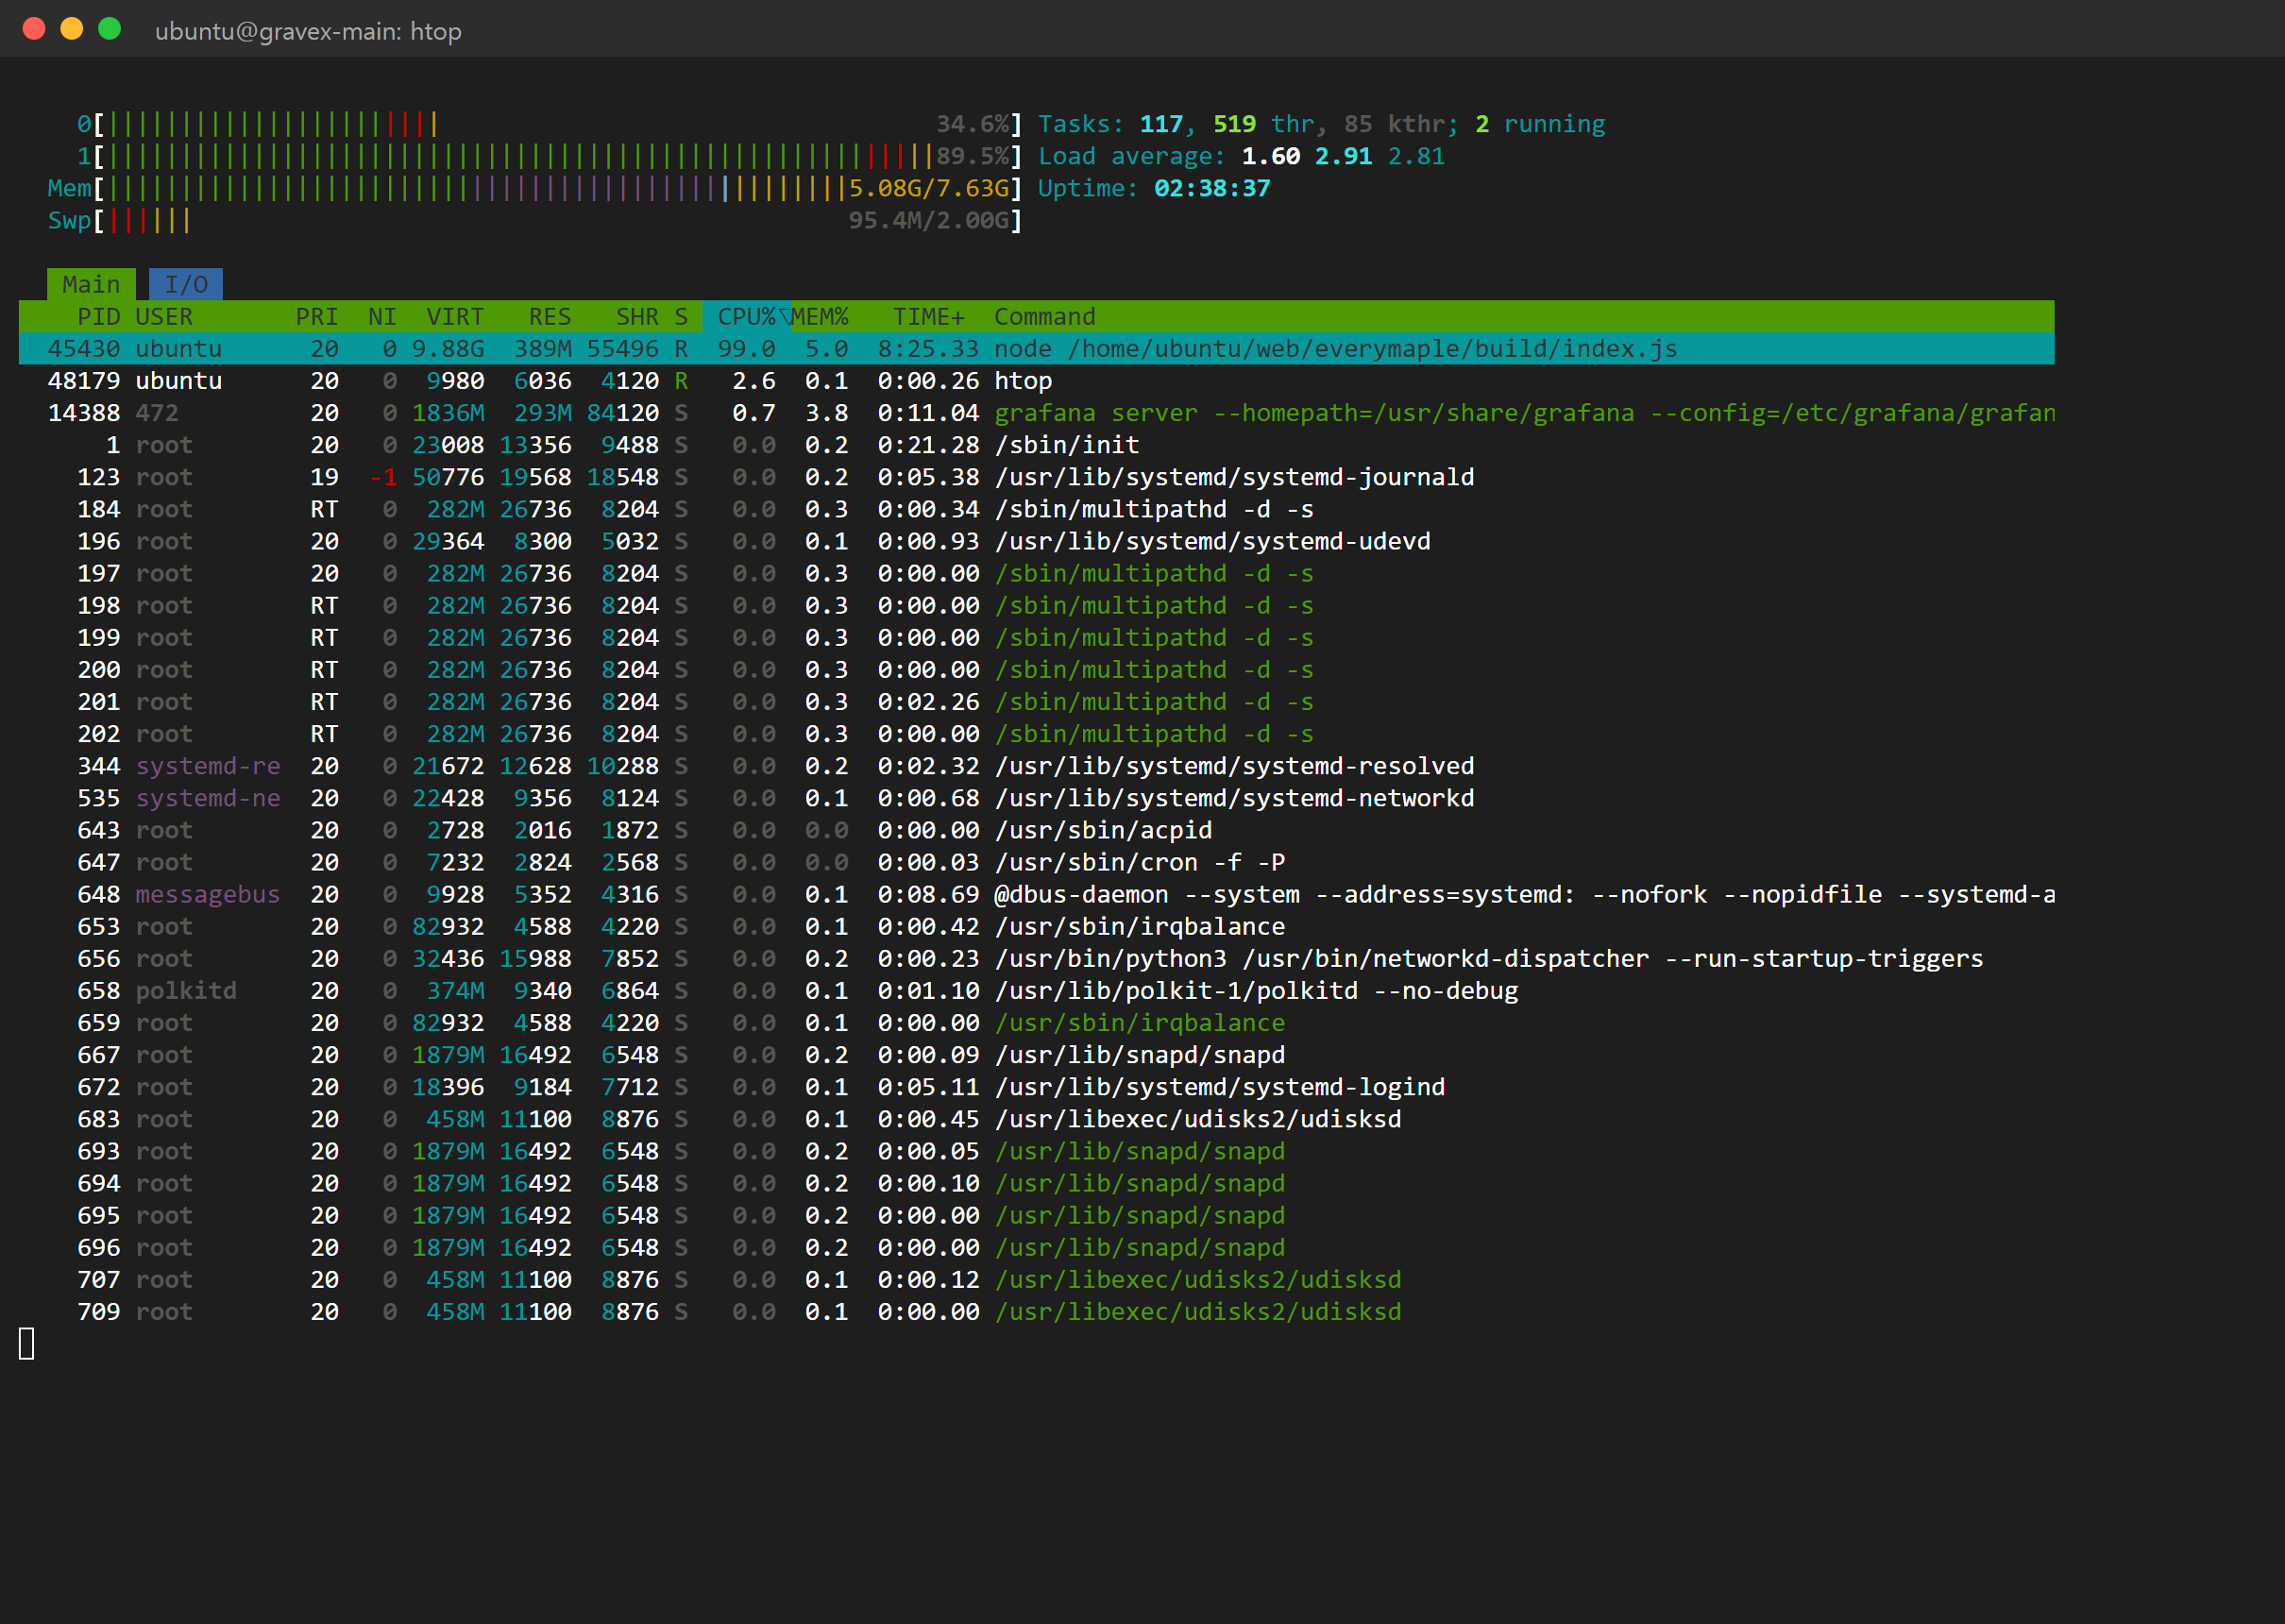 맥에서
ssh gravex-main 붙어서 본 htop. 메모리 7.6GB 중 5GB
3단계: 전환 (다운타임 15분)
원래 Jarvis 계획은 논리 복제를 걸어서 새 서버가 실시간으로 따라오게 해 두고, 내일 아침 7시 트래픽 제일 적을 때 DNS만 바꾸는 거였다. 근데 그러려면 EC2 Postgres 설정을 바꾸고 재시작해야 하고, 큰 DB를 다시 복사하느라 한 시간 넘게 걸린다.
그래서 내가 "그냥 모든 도메인에 이전 중이라는 정적 페이지 띄워 두고, 그동안 덤프해서 옮기면 되지 않아? nginx로 서빙하면 될 것 같은데" 했더니 그게 더 낫다고 바로 갈아탔다. 그리고 "지금 트래픽 별로 없으니 지금 바로 해 줘."
점검 페이지는 EC2 nginx의 server 블록마다 include 한 줄만 넣었다.
# /etc/nginx/snippets/maint.conf — server 블록마다 include 한 줄
error_page 503 @maint;
location @maint {
    root /var/www/maint;
    try_files /index.html =503;
    add_header Cache-Control "no-store" always;
    add_header Retry-After "3600" always;
}
return 503;
- 503 + Retry-After라서 구글은 "잠깐 점검 중"으로 보고 순위를 안 깎는다
- no-store라서 CloudFront가 점검 페이지를 캐시하지 않는다. 다시 열리면 바로 새 서버가 보인다
- 앱이 멈추니까 DB 쓰기도 같이 멈춘다. 그 사이 데이터가 어긋날 일이 없다
그다음 순서는 이랬다.
- 점검 페이지 띄우고 EC2 앱·크론 전부 멈춤
- DB 9개를 다시 덤프해서 새 서버로 복원 (8분). 국토 DB만 오전 사본을 그대로 썼다. 표마다 세어 보니 사용자 데이터 차이는 없었고, 크롤러가 다시 채우는 분양 거래 101건 정도만 달라서 안 옮김
- 검증: 양쪽 표 149개의 행 수를 다 맞춰 봤다. 하나라도 다르면 안 열기로 했는데 전부 같았다
- Redis·Typesense 스냅숏, 오늘 배포한 앱 파일 다시 동기화
- 새 서버의 크론·워커·알림·백업·인증서 갱신 켜기
- Route53 A 레코드 17개를 새 IP로. CloudFront 원본이 IP가 아니라 도메인 이름이라 CloudFront 설정은 손댈 게 없었다. 미리 TTL을 60초로 줄여 둬서 1분 안에 다 넘어감
- GitHub 저장소 10개의 배포 시크릿(서버 주소·호스트 키) 교체. 다음 배포부터 새 서버로 간다
- Lightsail 매일 06시 자동 스냅숏 켜기 (7개 보관)
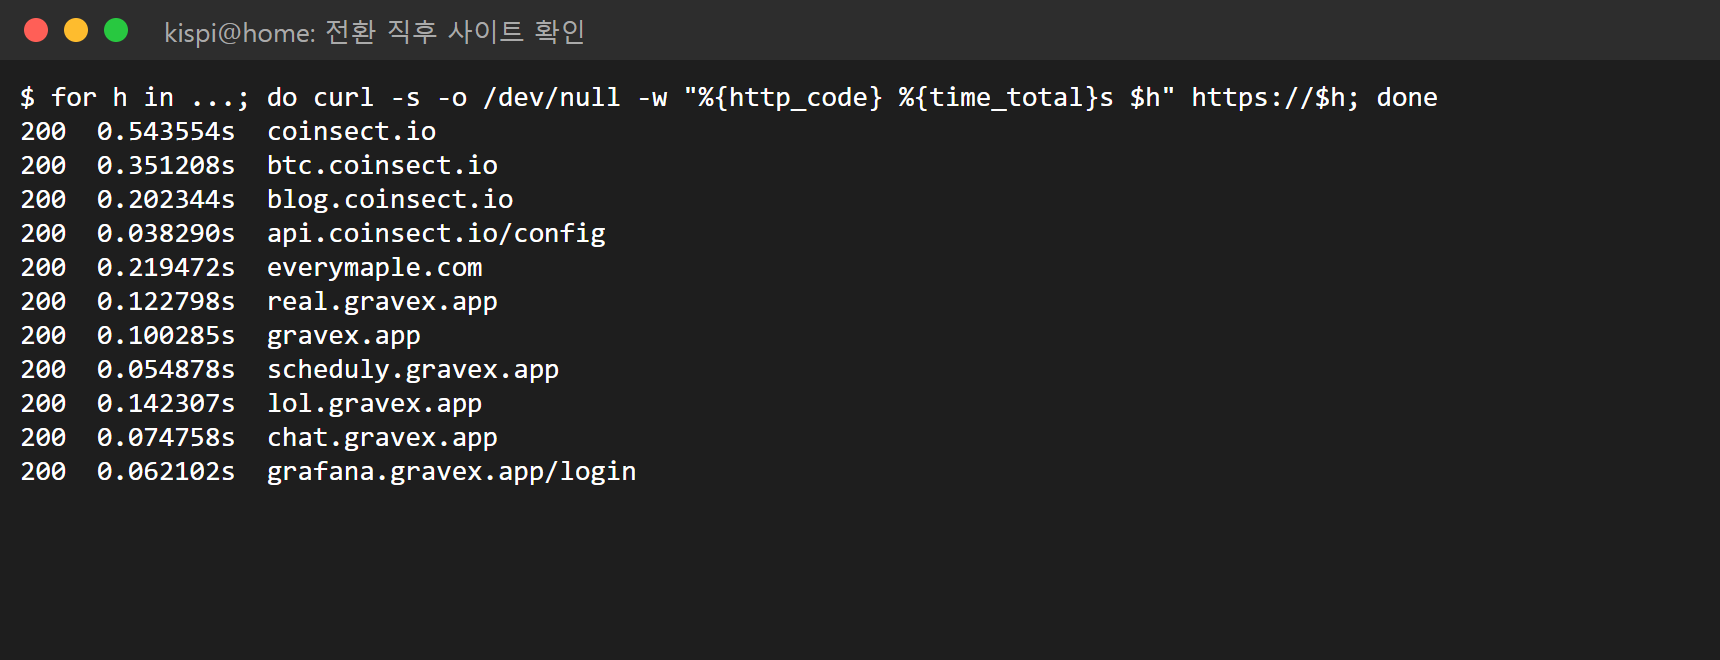 전환 직후 진짜 도메인으로 확인
EC2는 앱과 크론을 다 끈 채로 며칠 둔다. 문제가 생기면 DNS만 돌리면 1분 안에 원래대로다.
비용은 어떻게 되나
| 월 비용 (세금 제외) | 전 | 후 |
|---|---|---|
| EC2 t3.medium (예약 인스턴스) | $22.61 | - |
| EBS 80GB + 스냅숏 | $11.34 | - |
| 공인 IPv4 | $3.60 | - (Lightsail 고정 IP는 붙어 있으면 무료) |
| Lightsail 2GB (웹소켓 프록시) | $11.61 | - (8GB로 합침) |
| Lightsail 8GB | - | $44 |
| Lightsail 자동 스냅숏 | - | 몇 달러 (GB당 월 $0.05) |
| 합 | 약 $49 | 약 $47 |
금액만 보면 거의 같다. 근데 같은 돈에 받는 게 다르다.
- 메모리 6GB(두 대 합) → 8GB, 한 대에 몰려 있으니 남는 메모리를 서로 나눠 쓴다
- 디스크 140GB(두 대 합) → 160GB, 그리고 EBS 따로 안 냄
- 무료 전송 100GB → 5TB. 예전에 데이터 전송비로 월 $100 넘게 나올 뻔했던 일 같은 걸 이제 신경 안 써도 된다
- CPU 크레딧이 바닥나도 초과 과금이 없다
솔직히 말하면 당장은 돈이 더 나간다. EC2를 예약 인스턴스(선결제 없음, 1년)로 사 둬서 2027년 3월 2일까지는 서버를 끄든 말든 $22.61이 매달 나간다. EC2를 지우면 EBS·IP·스냅숏 $15는 바로 빠지지만, 남은 4개월은 한 달에 $20쯤, 합쳐서 $80쯤 더 내는 셈이다. 메모리 때문에 서버가 통째로 먹통 되는 걸 한 번 겪고 나니 이 정도는 낼 만하다고 봤다.
AI가 한 것, 내가 한 것
내가 한 것
- 슬랙에서 "실험해 보자, 아니면 말면 되니까", "다 띄워 주면 내가 써 볼게", "지금 바로 해 줘" 같은 결정
- 점검 페이지 아이디어 (이건 내가 냄 ㅋㅋ)
- 회사 맥에서 hosts 고치고 사이트 써 보기
AI가 한 것
- 실험 설계(판단 기준까지), 인스턴스 만들고 지우기, 쿼리 비교
- 새 서버 세팅, 전 제품 배포, DB 10개 복원, 크론 끄고 켜기
- 점검 페이지, 재덤프·검증, DNS 17개, 배포 시크릿 10곳, 자동 스냅숏
- 새 서버 전용 SSH 키 만들고 집 PC PuTTY에 더블클릭으로 붙는 프리셋까지
- 그리고 내가 "왜 이렇게 압축이 잘 돼?" 같은 걸 물으면 설명해 주기
AI 작업 시간은 1시간 반쯤, API 단가로 환산한 Claude 사용량은 이틀 치 대화 다 합쳐 약 $12다.
몇 년 전이었으면 이런 이전은 주말 하루를 통째로 잡고, 체크리스트 쓰고, 새벽에 긴장하면서 했을 거다. 이번엔 회사에서 슬랙 보면서 결정만 했는데 오후 3시에 끝나 있었다. 사람이 한 건 무엇을 할지, 언제 할지, 얼마나 위험을 감수할지 정하는 것뿐이었다.
남은 것
- 새 서버 CPU 크레딧이 실험·복원에서 거의 다 써서 바닥이다. 며칠은 기준선 30%로만 도는데, 크레딧이 다시 차는지 지켜보는 중
업비트 웹소켓 프록시(Lightsail 2GB) 합치기→ 같은 날 합쳤다. 프록시 하나라 10분, 접속해 있던 20여 명은 자동으로 새 서버에 다시 붙었다. 이 프록시가 한 달에 내보내는 356GB도 Lightsail 8GB의 5TB 안이다- daily 크론들 며칠 잘 도는 거 보고 EC2 정리
끗